Das Journal29. August 202610 Min. Lesezeit
Binet wollte helfen, nicht sortieren
Wie aus einer Schulhilfe eine Rangordnung wurde
Frankreich hatte die Schulpflicht ausgeweitet, und damit saßen Kinder mit sehr unterschiedlichen Voraussetzungen erstmals gemeinsam in den Klassen. 1904 setzte das Unterrichtsministerium eine Kommission ein, die klären sollte, wie sich jene Kinder erkennen ließen, die vom regulären Unterricht nicht ausreichend profitierten. Die bis dahin übliche Alternative war ein unsystematisches Urteil von Lehrkräften oder Ärzten — ebenfalls anfällig für Vorurteile. Alfred Binet und der Arzt Théodore Simon entwickelten dafür kurze Aufgaben zu Aufmerksamkeit, Gedächtnis, Verständnis und praktischem Urteil.
Das Ziel war nicht, eine metaphysische Menge „Intelligenz“ zu wiegen. Es ging darum, Kinder zu finden, die besondere Unterstützung benötigten. Wenig später diente dasselbe Verfahren jenseits des Atlantiks dazu, Menschen nach angeborenem Wert zu ordnen. Diese Reise ist die eigentliche Geschichte des Intelligenztests.
Paris, Schulpflicht und ein Praxisproblem
Die Aufgaben der Skala von 1905 wurden mit dem Alter schwieriger: einfachen Anweisungen folgen, Sätze nachsprechen, Unterschiede erklären, Bilder verstehen, praktische Probleme lösen. Entscheidend war das Muster im Vergleich zu Kindern ähnlichen Alters. Die Revision von 1908 ordnete die Aufgaben nach Altersstufen und brachte damit das Konzept des „mentalen Alters“ hervor: Was lösen Kinder einer bestimmten Altersgruppe gewöhnlich? Eine dritte Fassung erschien 1911, im Todesjahr Binets.
Binet warnte vor der Verdinglichung seines eigenen Werkzeugs. Ein schwaches Ergebnis sei kein unveränderliches Etikett; Unterricht und Übung könnten Leistungen verändern. Die Skala sollte kein Gehirngewicht und keine Seele messen, sondern pädagogischen Bedarf sichtbar machen.
Quelques philosophes récents semblent avoir donné leur appui moral à ces verdicts déplorables en affirmant que l’intelligence d’un individu est une quantité fixe, une quantité qu’on ne peut pas augmenter. Nous devons protester et réagir contre ce pessimisme brutal ; nous allons essayer de démontrer qu’il ne se fonde sur rien.
Schon hier lag ein Dilemma, das keine Messung auflöst. Um Hilfe gerecht zu verteilen, musste die Verwaltung Kategorien bilden. Dieselbe Kategorie konnte zur Aussonderung dienen. Ein Messinstrument ist deshalb nie nur eine neutrale Antwort; es verändert den institutionellen Weg der gemessenen Person. Ob eine Diagnose Förderung oder Abschiebung bedeutet, entscheidet das System nach dem Test.
| Jahr | Schritt |
|---|---|
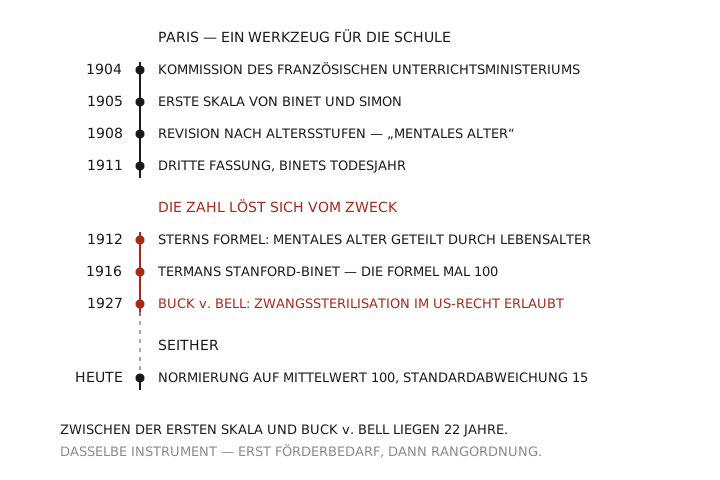
| 1904 | Kommission des französischen Unterrichtsministeriums |
| 1905 | Erste Skala von Binet und Simon |
| 1908 | Revision nach Altersstufen, „mentales Alter“ |
| 1911 | Dritte Fassung, Binets Todesjahr |
| 1912 | Sterns Formel: mentales Alter geteilt durch Lebensalter |
| 1916 | Termans Stanford-Binet, Formel mal 100 |
| 1927 | Buck v. Bell |
| heute | Normierung auf Mittelwert 100, Standardabweichung 15 |
Binet hatte zuvor Hypnose, Wahrnehmung, Gedächtnis und die Leistungen seiner Töchter untersucht. Einige frühe Arbeiten enthielten methodische Fehler, die er öffentlich korrigierte. Diese Bereitschaft prägte sein späteres Denken: Intelligenz erschien ihm nicht als einfache Substanz, die ein Test fehlerfrei freilegt. Er entwickelte Übungen, die Aufmerksamkeit, Selbstkontrolle und Lernstrategien fördern sollten.
Seine Warnungen gegen eine „brutale“ Zahlensicht werden häufig so gelesen, als habe er jede stabile Differenz bestritten. Auch das wäre zu einfach. Binet hielt Unterschiede für messbar und praktisch relevant, aber nicht für eine unveränderliche Rangordnung des menschlichen Werts. Als humane Gegenfigur zu den späteren Eugenikern taugt er nur bedingt: Er arbeitete in den Kategorien seiner Zeit und sprach über Kinder in Begriffen, die heute stigmatisierend sind. Sein Verdienst liegt weniger in moralischer Fehlerfreiheit als in der methodischen Bescheidenheit gegenüber dem eigenen Instrument.
Théodore Simon arbeitete als Arzt mit Kindern in Einrichtungen und brachte klinische Erfahrung in die Skala ein. Die geläufige Kurzform „Binet-Test“ lässt seinen Beitrag verschwinden. Wissenschaftliche Namen funktionieren wie Marken: Ein prägnanter Protagonist sammelt Anerkennung, während Kooperation und institutionelle Arbeit unsichtbar werden. Die gemeinsame Autorenschaft ist keine Fußnote, sondern der Hinweis darauf, dass die Skala aus dem Austausch von Psychologie, Medizin und Schule entstand.
Das Instrument wechselt den Kontinent
Henry H. Goddard brachte eine englische Fassung in die USA und nutzte sie unter anderem an der Vineland Training School. Er vertrat die Vorstellung, „Schwachsinn“ sei häufig erblich, und verband Testwerte mit eugenischer Politik. Seine Studie zur Familie „Kallikak“ stellte eine angeblich gute und eine angeblich degenerierte Abstammungslinie gegenüber; spätere Analysen zeigten schwere genealogische und interpretative Probleme.
Auf Ellis Island wurden Einwanderer unter belastenden Bedingungen getestet. Die populäre Behauptung, der Test habe direkt massenhaft Einreisen entschieden, ist in dieser Einfachheit historisch umstritten. Sicher ist, dass Forschende niedrige Ergebnisse von Menschen mit wenig Englisch, geringer Schulerfahrung und großem Stress als Beleg angeborener Minderwertigkeit deuteten. Übersetzung ist eben nie nur Sprache. Aufgaben tragen Schulerfahrung, englische Begriffe und kulturelle Erwartungen mit sich; wer neu eingewanderte Menschen unter Zeitdruck mit unbekannten Formaten prüft, misst auch Bildung, Armut und Gesundheit.
Lewis Terman überarbeitete die Aufgaben, normierte sie an einer amerikanischen Stichprobe und veröffentlichte 1916 den Stanford-Binet-Test. Auch er hielt Intelligenz für weitgehend erblich und befürwortete eugenische Maßnahmen. Von ihm stammt zugleich die populärste Rechenoperation der Psychologiegeschichte: Die Formel mentales Alter geteilt durch Lebensalter hatte William Stern 1912 vorgeschlagen; Terman multiplizierte sie mit 100 und machte den Intelligenzquotienten zur Alltagswährung. Die Zahl war administrativ attraktiv, weil Schulen, Militär und Behörden nun große Gruppen vergleichen konnten.
Termans berühmte Langzeitstudie sollte zeigen, dass hohe Begabung nicht mit körperlicher oder sozialer Schwäche einhergeht. Die „Termites“ wurden über Jahrzehnte begleitet und lieferten wertvolle Lebensverlaufsdaten. Die Auswahl war jedoch selektiv: überwiegend weiße, besser situierte Kinder, die Lehrkräften auffielen und Tests bestanden. Spätere Bildungs- und Berufserfolge spiegeln daher Fähigkeit, Herkunft, Auswahl und zusätzliche Aufmerksamkeit zugleich. Besonders lehrreich sind Personen, die die Auswahlschwelle knapp verfehlten und später außergewöhnliche Leistungen zeigten. Ein Schwellenwert verwandelt eine kontinuierliche Schätzung in zwei institutionelle Gruppen; direkt an der Grenze erhalten fast gleiche Menschen sehr verschiedene Chancen.
Im Ersten Weltkrieg testete die US-Armee große Zahlen von Rekruten. Army Alpha war sprach- und schriftbasiert, Army Beta sollte Menschen mit wenig Englisch oder geringer Literalität erfassen. Die Massentests versprachen, Aufgaben und Führungspotenzial effizient zuzuordnen, und etablierten die psychologische Prüfung als Verwaltungstechnologie.
Die Bedingungen waren unruhig, die Anweisungen ungewohnt, die Aufgaben kulturell geladen. Robert Yerkes und Kollegen berichteten Durchschnittsunterschiede zwischen Herkunftsgruppen, die öffentlich als mentale Hierarchie gelesen wurden und in die Einwanderungsdebatten einflossen.
Der methodische Kernfehler ist bis heute aktuell. Ein Test kann Gruppen unter bestimmten Bedingungen zuverlässig unterscheiden, ohne die Ursache des Unterschieds zu benennen. Zuverlässigkeit ist nicht Kausalität. Wer einen stabilen Abstand misst, hat noch nicht gezeigt, ob Gene, Bildung, Sprache, Gesundheit, Diskriminierung oder Aufgabenvertrautheit ihn erzeugen. Ein Unterschied kann exakt gemessen und trotzdem grundfalsch erklärt sein.
Von der Diagnose zum Zwang
Eugenische Bewegungen wollten die Fortpflanzung gesellschaftlich steuern. In den USA führten Gesetze zur Zwangssterilisation Zehntausender Menschen — häufig Menschen mit Behinderungen, arme Frauen und Angehörige marginalisierter Gruppen. Tests lieferten einen wissenschaftlich klingenden Teil der Legitimation; sie waren nicht die einzige Ursache.
Buck v. Bell erlaubte 1927 im US-Recht die Sterilisation einer jungen Frau, deren angebliche erbliche „Minderwertigkeit“ schlecht belegt war. Institutionelle Interessen, soziale Vorurteile und juristische Macht verwandelten eine umstrittene Diagnose in irreversiblen körperlichen Zwang.
Die ethische Grenze liegt nicht erst bei der falschen Messung. Selbst ein perfekt gemessener kognitiver Unterschied gäbe niemandem das Recht, über die Fortpflanzung eines anderen zu verfügen. Messkritik und Menschenrechte sind verschiedene Schutzlinien; gebraucht werden beide.
Was ein IQ-Wert heute bedeutet
Moderne Tests normieren Ergebnisse meist mit einem Mittelwert von 100 und einer Standardabweichung von 15. Ein Wert beschreibt die Position relativ zu einer altersbezogenen Normstichprobe. Er ist keine Prozentzahl richtiger Intelligenz und kein festes Eigentum wie die Körpergröße. Für Erwachsene eignet sich ein linear wachsendes „mentales Alter“ ohnehin schlecht; moderne Tests verwenden Abweichungswerte relativ zur Altersnorm. Der Name IQ blieb, seine statistische Bedeutung änderte sich.
Jeder Wert besitzt ein Konfidenzintervall. Tagesform, Messfehler und die Auswahl der Untertests beeinflussen das Ergebnis. Ein Bericht, der 92 statt eines plausiblen Bereichs nennt, erzeugt Scheingenauigkeit. Nahe an einem Grenzwert können wenige Punkte große Folgen haben, obwohl die statistische Unsicherheit über die Grenze hinausreicht. Auch die Normen altern: Bildungszugang, Gesundheit und Testvertrautheit verändern Leistungen über Generationen, bekannt als Flynn-Effekt, dessen Verlauf nicht überall gleich ist. Ohne Neunormierung verschiebt sich die Bedeutung derselben Rohleistung.
Viele kognitive Aufgaben korrelieren positiv: Wer in einem Bereich gut abschneidet, erzielt im Durchschnitt auch in anderen eher höhere Werte. Charles Spearman nannte den gemeinsamen Faktor „g“; moderne hierarchische Modelle verbinden einen allgemeinen Faktor mit breiteren und spezifischen Fähigkeiten. Die statistische Existenz eines Faktors sagt aber nicht, dass im Gehirn eine Substanz „Intelligenz“ sitzt. Faktoren fassen Kovariation zusammen; ihre Ursachen können vielfältig sein. Bildung kann mehrere Fähigkeiten zugleich stärken, grundlegende Verarbeitungsmechanismen können auf verschiedene Aufgaben wirken.
Deshalb ist es menschenanalytisch besonders gefährlich, Fähigkeit mit Wert zu verwechseln. Zwei ähnliche IQ-Werte können aus ganz unterschiedlichen Profilen entstehen; Sprache, Arbeitsgedächtnis, Verarbeitungsgeschwindigkeit und räumliches Denken tragen verschieden bei. Ein Test kann vorhersagen, wie gut bestimmte schulische Anforderungen bewältigt werden. Er misst nicht Moral, Kreativität, Fürsorge oder das Recht auf Selbstbestimmung.
Kulturfreiheit, Nutzen und Schaden
Man kann die Sprachlast verringern, vertraute Aufgaben wählen und Normgruppen verbessern. Vollständig kulturfreie Intelligenztests gibt es kaum. Schon die Annahme, ein abstraktes Muster schnell und allein zu lösen sei die relevante Form von Leistung, enthält kulturelle und institutionelle Werte.
Fairness bedeutet nicht, Unterschiede zu leugnen. Sie verlangt zu prüfen, ob Aufgaben in allen Gruppen dieselbe Fähigkeit messen, ob Vorhersagen gleich gut funktionieren und ob Entscheidungen unnötig benachteiligen. Ein Test kann psychometrisch vergleichbar und sein Einsatz trotzdem ungerecht sein. Mehrsprachige Diagnostik braucht qualifizierte Sprachmittlung und Angaben zur Bildungsbiografie; eine wortwörtliche Übersetzung erhält weder Schwierigkeit noch Bedeutung, und Normen aus einem Land sind keine Naturkonstanten.
Auch der Raum selbst wirkt. Menschen wissen, welche Gruppen als weniger intelligent gelten; macht eine Situation dieses Stereotyp salient, können Sorge und Selbstbeobachtung das Arbeitsgedächtnis belasten. Die Forschung zu Stereotype Threat hat heterogene Effekte und Replikationsdebatten erlebt und taugt nicht als universeller Erklärschlüssel. Breiter belegt ist die Grundeinsicht: Testleistung entsteht in einer sozialen Situation, in der Angst, Misstrauen, Schlaf, Schmerz und die Beziehung zur untersuchenden Person mitwirken. Wer wiederholt erlebt hat, dass Institutionen Tests gegen die eigene Gruppe verwenden, bringt begründetes Misstrauen mit. Vertrauen ist deshalb kein weicher Zusatz, sondern Teil einer gültigen Messung.
Bei einer fundierten Abklärung kann ein Test zeigen, ob schulische Probleme breit oder spezifisch sind, ob eine Leistung nach neurologischer Erkrankung abgenommen hat oder welche Unterstützung angemessen wäre. Er ist ein Baustein neben Gespräch, Entwicklungsverlauf, Schulbeobachtung und medizinischen Informationen. Hilfreich wird der Wert, wenn er eine konkrete Entscheidung verbessert: mehr Zeit, passender Unterricht, barrierefreie Kommunikation, gezielte Rehabilitation. Schädlich wird er, wenn er ohne Fragestellung erhoben, als unveränderlich ausgegeben oder zur sozialen Rangordnung genutzt wird.
Etiketten wirken in beide Richtungen. Ein achtjähriges Kind, das Aufgaben von Sechsjährigen löste, konnte mit einem „mentalen Alter“ von sechs beschrieben werden — für die Unterrichtsplanung anschaulich, als Beschreibung der Person falsch. Dieses Kind hat den Körper, die Beziehungen, Interessen und Lebenserfahrung eines Achtjährigen. Das Etikett senkt Erwartungen: Erwachsene sprechen einfacher, geben weniger Verantwortung, übersehen ungleichmäßige Profile. So wirkt die Messung auf die Umwelt zurück, die wiederum die Leistung beeinflusst.
Am oberen Ende geschieht Ähnliches. Hohe Werte öffnen Förderangebote und werden doch zur Identitätsschablone: Erwartungsdruck, Vermeidung von Aufgaben mit Fehlerrisiko, gewöhnliche Schwierigkeiten als Absturz gedeutet. „Hochbegabt“ erklärt weder Motivation noch emotionale Reife. Umgekehrt darf aus der Kritik an Labels nicht folgen, besondere Lernbedürfnisse zu ignorieren; Unterforderung ist real. Carol Dwecks populäre Unterscheidung von statischem und wachstumsorientiertem Denken wird dabei oft zu simpel angewandt. Anstrengung allein beseitigt keine Barrieren, und Lob für „Mindset“ ersetzt keine Ressourcen.
Eine professionelle Rückmeldung übersetzt Zahlen deshalb in Grenzen und Möglichkeiten. Sie erklärt die Unsicherheit, vermeidet abwertende Altersvergleiche und nennt die Faktoren, die das Ergebnis beeinflusst haben könnten. Die getestete Person hat ein Recht darauf, mehr zu erfahren als eine Zahl. Die Frage lautet nicht nur „Wie hoch?“, sondern „Welche Aufgabe scheitert aus welchem Grund, und welche Hilfe verändert das Ergebnis?“
Was bleibt
Die Geschichte lehrt nicht, Messung abzuschaffen. Sie lehrt, die soziale Reise einer Messung mitzudenken. Binet baute ein pädagogisches Warnsignal, andere machten daraus eine Rangliste vermeintlicher Natur — dass dasselbe Instrument beides leisten konnte, zeigt: Tests haben keine Ethik aus sich selbst. Wenn Prüfungen Leistung scheinbar objektiv ordnen, wirkt die entstehende Hierarchie verdient. Doch Testergebnisse hängen auch von Familie, Schule, Gesundheit und gesellschaftlicher Sicherheit ab. Der Einwand lautet nicht, alle Menschen hätten identische Fähigkeiten. Er lautet, dass Unterschied und Verdienst nicht dasselbe sind. John Rawls’ Gedankenexperiment stellt die praktische Frage: Welche Regeln für Testfolgen würden wir wählen, wenn wir nicht wüssten, mit welcher Begabung, Sprache oder Behinderung wir geboren werden?
Praktisch heißt das, jeder Messung einen Satz mitzugeben: Dieses Ergebnis gilt für diese Person, unter diesen Bedingungen, im Vergleich zu dieser Norm und für diesen begrenzten Zweck. Fehlen die Angaben, wird aus Statistik Charakterkunde. An jedem Testergebnis lässt sich zudem dieselbe Frage stellen, die schon Binets Auftrag von 1904 zugrunde lag. Öffnet diese Zahl den Zugang zu Lernen und Selbstbestimmung, oder schließt sie einen Menschen ein?
Quellen und warum sie hier stehen
Binet, A., & Simon, T. (1905). Méthodes nouvelles pour le diagnostic du niveau intellectuel des anormaux. L'Année Psychologique, 11, 191–244.
Die Skala von 1905 in ihrer Erstveröffentlichung — Grundlage aller Angaben zu Aufgabenart und Zweck des Verfahrens.
Binet, A. (1909). Les idées modernes sur les enfants. Paris: Flammarion.
Binets eigene Warnung vor der Verdinglichung: Quelle des zitierten Satzes gegen den „pessimisme brutal“, Kapitel V.3, S. 141.
Terman, L. M. (1916). The Measurement of Intelligence. Boston: Houghton Mifflin.
Die amerikanische Revision, der Stanford-Binet-Test und die Multiplikation von Sterns Formel mit 100.
Gould, S. J. (1981/1996). The Mismeasure of Man. New York: Norton.
Die klassische Kritik an Goddard, Yerkes und den Army-Tests — Grundlage der Darstellung von Kallikak-Studie und Massentestung.
Carson, J. (2007). The Measure of Merit: Talents, Intelligence, and Inequality in the French and American Republics, 1750–1940. Princeton: Princeton University Press.
Der historische Vergleich, der erklärt, warum dasselbe Instrument in Frankreich Förderung und in den USA Rangordnung bedeutete.
Nicolas, S., Andrieu, B., Croizet, J.-C., Sanitioso, R. B., & Burman, J. T. (2013). Sick? Or slow? On the origins of intelligence as a psychological object. Intelligence, 41(5), 699–711.
Rekonstruiert Binets Auftrag und die Entstehung der Skala aus der Quellenlage — Beleg für die Kommission von 1904 und Simons Anteil.